OpenAI は11月6日 (米国時間)、実験室の生データを AI エージェントがどこまで読めるかを測る試験「BioBasicsBench」を発表した。酵素設計の Ligo と作った100問で、最上位の GPT-6 Astra が取れた点は66.7%だった。
舞台は実験室だが、写真や表を AI に渡して「どう読む?」と聞く人にも関係がある。AI が外すときの形が、具体的に記録されたからだ。この件は速報で第一報を出している。ここでは得点の中身と、手元の使い方に持ち帰れる部分を分けておく。
100問の材料は、失敗も混じる実験室の生データ
報道によると OpenAI の問題意識は、これまでの評価が論文向けに選ばれた図や画像に頼り、失敗した実験や判断に迷う画像、食い違う観察が抜け落ちていたことにある。
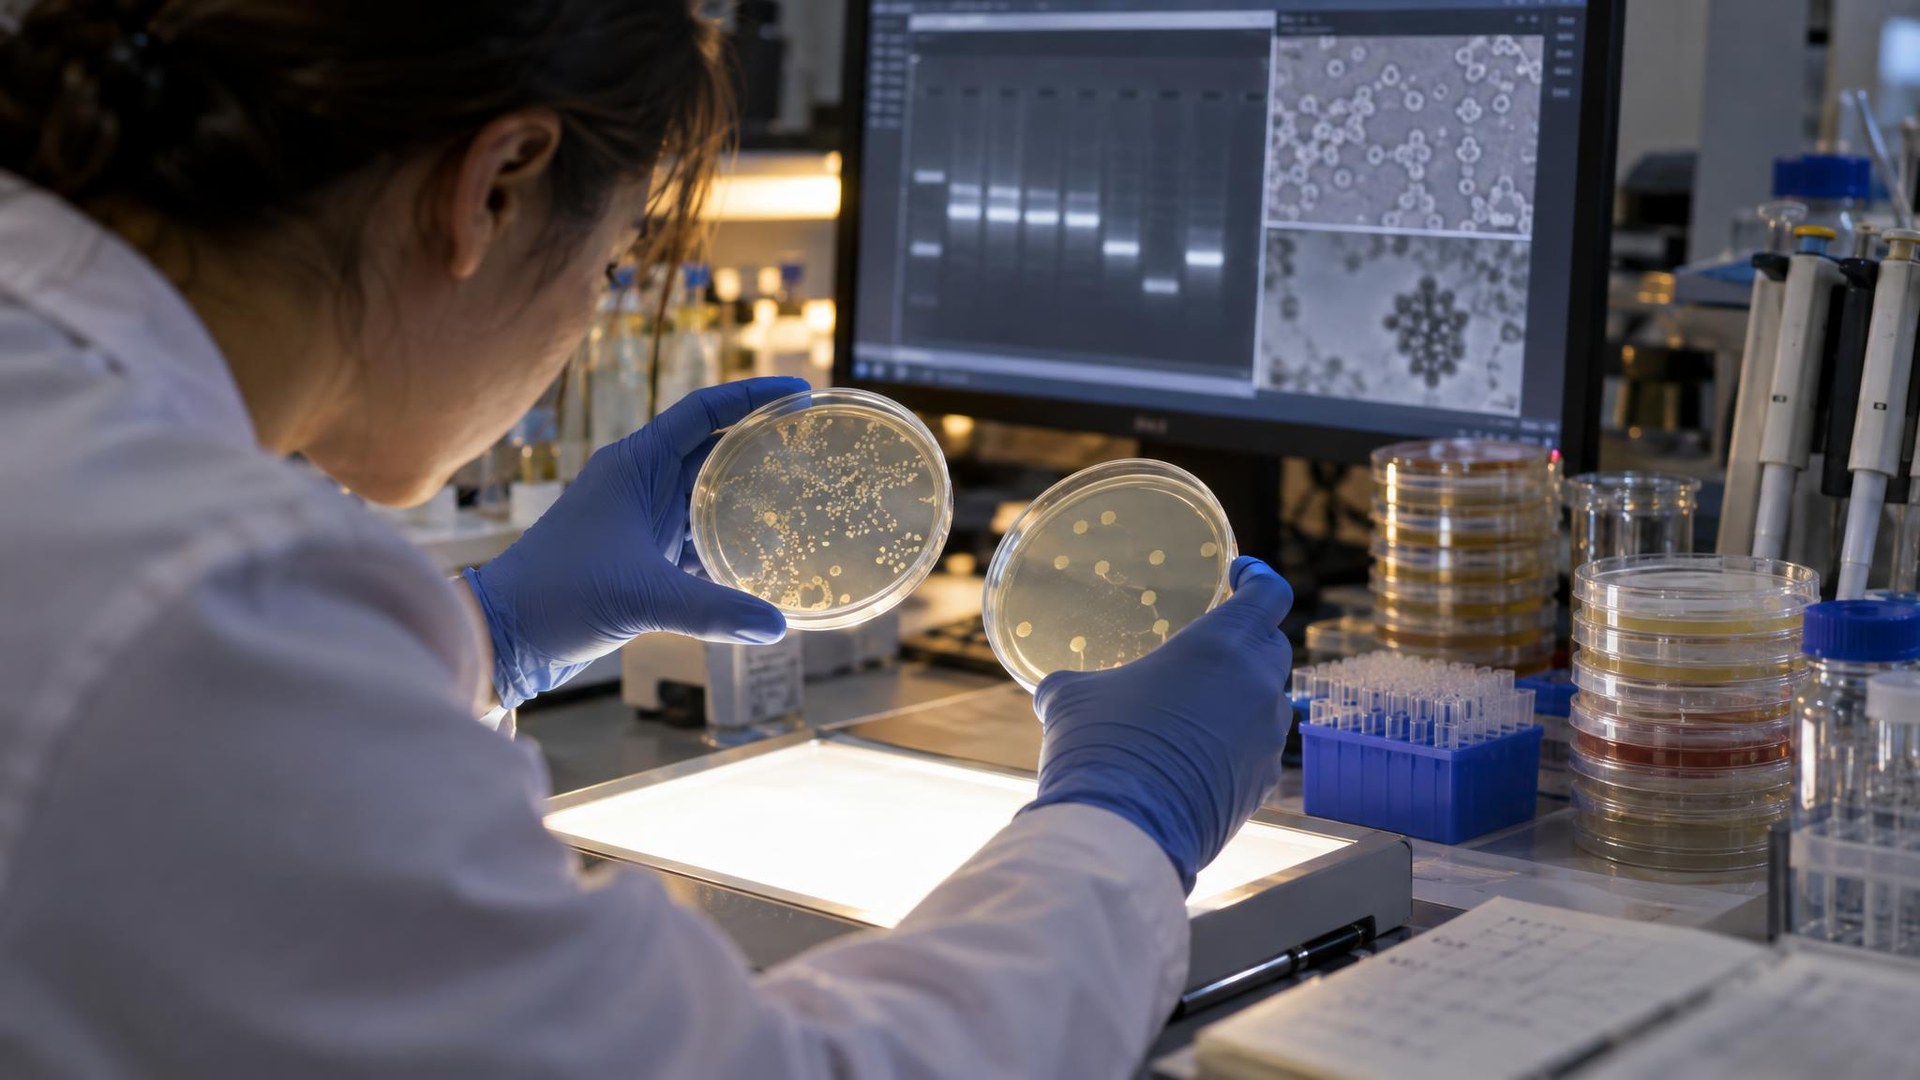
BioBasicsBench は、Ligo の科学者が自分たちの実験から問題を書いた。入力は電気泳動のゲルの画像、培養皿の写真、顕微鏡の画像、DNA の読み取り結果、測定機器の書き出しデータ、作業の動画などだ。領域はタンパク質、画像解析、定量、核酸、分子クローニング (DNA 断片を菌に組み込んで増やす作業) の5つに分かれる。
採点は正誤の二択ではない。数値の正しさ、根拠の筋道、証拠が足りないと認められるかに点がつく。得点は、取れる点のうち何%を取れたかの平均だ。問題は、作者ではない Ligo の科学者、社外の博士レベルの実験科学者、最後の社内確認という3段階の見直しを通っている。
世代で開いた得点差と、その読み方
OpenAI は7モデルを、思考量の設定を変えた37通りで、1問あたり5回ずつ試した。結果は18,500件になる。全モデルで比べられる xhigh という設定の得点は次のとおり。
- GPT-6 Astra: 66.7%
- GPT-6.1 Sol: 62.0%
- GPT-5.6 Sol: 43.8%
- GPT-6 Luna: 38.3%
- GPT-5.5: 35.4%
- GPT-5.4: 33.2%
- GPT-5.2: 31.2%
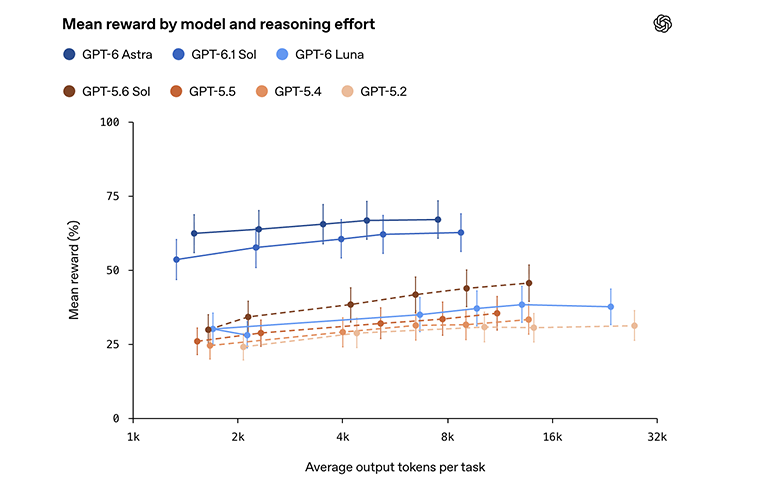
長く考えさせれば届く差でもなかった。Astra の1問あたりの平均出力は4,704トークンで、GPT-5.6 Sol の9,099トークンの約半分だ。OpenAI が X に載せた図でも、Astra は思考量を最も絞った設定で6割強あり、GPT-5.6 Sol の最も多い設定の4割台半ばを上回っている。OpenAI は、画像や動画をそのまま扱う力の伸びが鍵かもしれないと見ている。
ただし語の範囲は狭く取りたい。これは開発元自身の発表で、比べているのは自社のモデルだけだ。人間の基準値も示されていないので、66.7%が研究者より上か下かはこの数字から言えない。問題と採点基準が公開されているかも、確認できた報道には書かれていない。OpenAI 自身も、得点が上がっても実験室で信頼できる判断ができるとはまだ言えない、としている。
手書きのラベルは読めても、思い込みで外す
Astra が見抜いた場面は分かりやすい。DNA を組み込む実験で、GPT-5.6 Sol はコロニー (菌の塊) が出なかった皿を、陰性対照として結論の根拠にした。Astra は皿の手書きラベルから、実験で使ったアンピシリンとは別のカナマイシンの皿だと気づき、対照として使えないと退けた。
同じ Astra が外した場面も3つ記録されている。
- コロニー PCR: レーンを正しく2組に分けながら、大きい産物が出たほうが成功と決めてかかり、4・6・7・8番を選んだ。基準の答えは5・9・10番で、元のプラスミドが残った菌を選ぶ誤りになる
- 顕微鏡の画像: 途中のメモではピントで明暗が変わると書いていたのに、結論では液胞は周囲より暗いと一般化した。同じ画像に明るい液胞があった
- コロニーの計数: 近接した菌を分けられず、見えるものを逃し、何もない場所に印をつけて、基準より約12%多く数えた。条件が固定なら、DNA の導入効率の見積もりも同じ割合で膨らむ
OpenAI は最初の例を、慣れた思い込みが対照の読みを上書きしたものと説明している。
手元の写真や表に持ち帰れる3つの確かめ方
この試験が測ったのは実験室の作業で、家計の表や家の写真を読む精度ではない。それでも外し方の形は、AI に資料を読ませる場面に置き換えて考えられる。
- 結論より先に、どの部分を根拠にしたかを書かせて、元の写真や表と照らす
- 「この材料では言えないことは何か」を聞く
- 数える作業は、一部だけでも自分で数え直す
どれも手間がかかり、AI で浮いた時間の一部を戻すことになる。根拠を書かせれば安心というわけでもない。液胞の例のように、途中で気づいたことを結論で捨てる場合があるからだ。元の資料を自分で読めない分野では照らし合わせ自体ができず、詳しい人に見てもらう段取りが要る。健康や安全にかかわる判断については、この試験は何も保証していない。
もう一つ、OpenAI はこの能力の追跡をバイオセーフティとバイオセキュリティの理解にも使うとしている。実験データを読む力は研究を助ける一方で、管理の議論の対象にもなる。
次に確かめたいのは、OpenAI が次のモデルを出すときの発表だ。BioBasicsBench の得点が載るか、陰性対照の読み違いやコロニーの数え間違いが減ったと書かれるかを見たい。比べる起点は、今回の発表ページ「Measuring how AI agents handle everyday wet-lab science」になる。
ことば
- 陰性対照 — 何も起きないはずの条件で同時に進める比較用の試料。結果を読む土台になるので、ここが狂うと結論全体が崩れる。今回は皿のラベル違いが問題になった。
- コロニー PCR — 菌の塊から DNA を増やし、狙った断片が入っているかを帯の大きさで確かめる方法。分子クローニングの日常作業で、今回の試験の失敗例にも出てきた。
あなたが最近 AI に読ませた写真や表で、元の資料と照らし直した箇所はいくつあっただろうか?