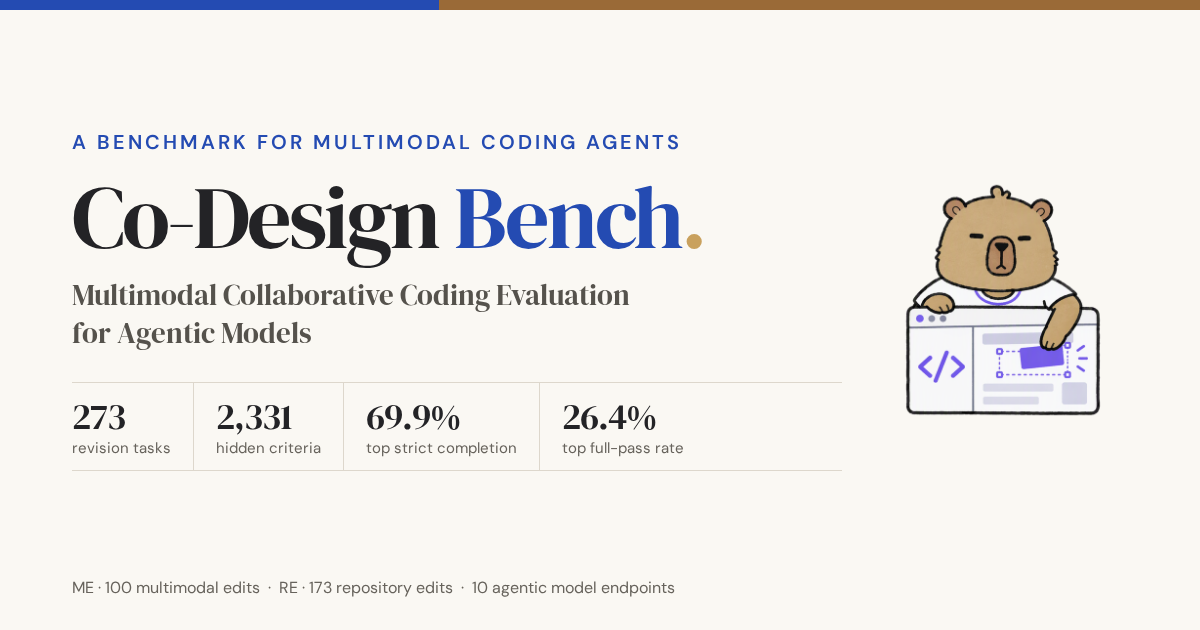
AI のコーディングエージェントに、実際の利用者の依頼どおりアプリを直させる新しいベンチマーク「Co-Design Bench」の論文が、2026 年 10 月 26 日に arXiv で公開された。最上位のモデルでも、1 課題あたり満たした合否基準は平均 69.9% で、全部の基準を満たせた課題は 26.4% だった。
 arXiv 論文「Co-Design Bench」(2026年10月26日・課題数・合格率)arXiv.org
言い換えると、4 件のうち 3 件近くは、どこかに手直しが残る。自分の家計簿アプリや趣味のサイトを AI に作らせる人にとって、これは「作れるかどうか」ではなく「どこまで任せて、どこから自分で確かめるか」の話になる。
実際の依頼から作った 273 の課題
論文によると、課題は 26,314 件の実際のコーディングのやり取りから集めた 37,463 件の依頼を重複なく整理し、そこから 273 件を選んだ。合否の基準は専門家が書いた 2,331 項目で、モデルからは見えないようになっている。プロジェクトページには、復旦大学、Alibaba グループ、浙江大学、香港中文大学、上海交通大学、南洋理工大学が並ぶ。
課題は 2 つの系統に分かれる。画像や音声、文書を見せて画面を直させる「マルチモーダル編集」と、既存のソースコード一式を直させる「リポジトリ編集」だ。採点は AI の審査役が完成したアプリをブラウザで動かして確かめ、合格の判定には別の審査役が、見せかけの画面や決め打ちの結果でないかを確かめ直す。
解説した The Decoder によると、選んだ課題には、利用者が依頼を言い直したり、変更を取り消したりした例が多く含まれる。つまり、人間でもつまずきやすい依頼が集められている。
「ほぼできた」が一番多い
The Decoder によると、最上位は OpenAI の GPT-6 Astra で、Anthropic の Claude Opus 5 と Alibaba の Qwen3.8-Max がそれに続いた。多くの課題で、エージェントは仕事の大半をこなしながら、少なくとも一つの細部を残していたという。
残りやすい場所にも傾向がある。レイアウト・デザイン・操作・中身のうち、3 種類や 4 種類の変更をまとめて頼むほど、どのモデルも点を落とした。計算量を増やしても大きくは伸びず、同じモデルでも動かす環境しだいで結果が大きく変わった。
ただし、この試験には限界もある。1 つの課題は 1 回の依頼で固定されていて、途中で質問したり直させたりする使い方は試していない。審査役の AI が間違える可能性もある。実際に人が横で会話しながら使えば、結果はもっと良くなるかもしれない。
作る速さと、仕上げを確かめる時間
週末に自分の道具を AI で作るとき、この結果から持ち帰れるのは 3 つだ。
- 頼む前に「できた」の条件を書く。ボタンを押したら何が起きればいいか、どの画面でどう見えればいいかを箇条書きにしておくと、残った一つを自分で見つけやすい
- 一度に頼む変更を絞る。見た目と動きと中身をまとめて直させるほど、取りこぼしが増える
- 元に戻せる状態で頼む。変更前のファイルを残しておけば、失敗した修正を取り消せる
コストもある。仕上げを確かめるには、自分で画面を触って動きを見る時間が要る。コードを読めない人は、どこが残ったのかを見つけにくい。お金や個人情報を扱う道具なら、確かめる手間はさらに増える。AI が作る速さが上がっても、この時間はすぐにはゼロにならない。
次に見るのは、Co-Design Bench のプロジェクトページの結果表だ。新しいモデルが加わったとき、26.4% という全部合格の割合がどこまで動くかで、任せられる範囲の広がり方が見えてくる。
ことば
- コーディングエージェント — 指示を受けて、自分でファイルを開き、コードを書き、動かして確かめるところまで進める AI。会話で答えるだけの AI より任せられる範囲が広い分、どこで止まったかを人が見る必要がある。
- ベンチマーク — 同じ課題と採点基準で、複数のモデルの力を比べるための試験。何を課題に選ぶかで結果が変わるので、点数だけでなく課題の作り方も読む価値がある。
あなたが AI に作らせた道具で、最後に自分で確かめた一つは何だっただろうか?